一个表格 Agent 连续把销售额放进透视表的行标签。把失败日志交给模型,让它重写操作手册,似乎就能解决问题。可是另一批相似失败来自工具升级:计划没有错,旧参数已经不再被接口接受。继续强化“正确放置销售额”的文字,对第二种失败没有帮助。
让 Agent 从经验中变好,首先需要决定经验说明了什么,以及究竟允许修改什么。 一次成功可能只是偶然,一次失败也未必由 Skill 导致。生成更多技能文件、保存更多反思,都不能直接证明下一次任务会更可靠。
本文沿一条完整的链路讨论这个问题:从轨迹提炼候选,用独立证据选择更新,再把有效变化巩固到长期技能库。重点比较 Trace2Skill、SkillOpt、SkillGrad 与 Memento-Skills;RRSI 补充更大编辑范围下的选择边界。本文的控制流程与表格案例属于工程建议和教学示例,研究实验均为作者报告。
1. 先分开三个会被写回的对象
一次执行至少留下三类东西:发生过什么、这次任务怎样恢复、以后遇到同类任务该怎样做。它们可以互相提供证据,但不应该被写成同一份持续覆盖的“记忆”。
| 对象 | 表格案例中的内容 | 更新方式 |
|---|---|---|
| 原始执行记录 | 请求、技能版本、工具参数、错误与文件差异 | 追加保存,支撑追溯 |
| 当前任务状态 | 修正后的字段映射、待验收文件 | 在本次运行中受控更新 |
| 可复用技能 | 适用条件、操作步骤与检查方法 | 形成候选,验证后发布 |
如果把当前任务中的文件名、单元格位置甚至正确答案直接沉淀成通用规则,下一次输入稍变就会失效。相反,只写一句“以后更加仔细”,又没有留下可执行的方法。一个有用的候选应该包含条件、动作和检查:什么时候采用这个做法,具体改变什么,怎样知道它生效。
对于工具升级,应先修适配器或版本约束;对于参数映射错误,可以修改步骤或示例;对于用户要求不清楚,应改善澄清流程。允许优化器输出“暂不修改 Skill”,有助于避免把整个系统的责任都推给文本。
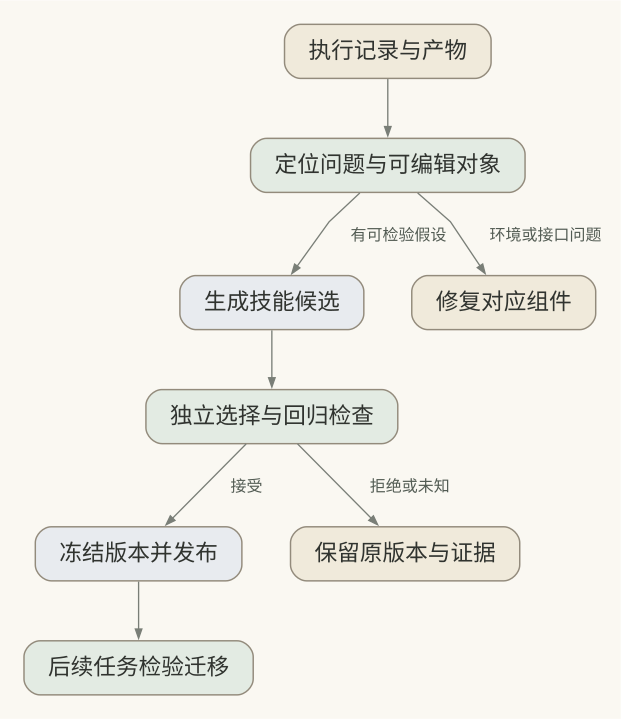
图 1:本文建议的经验写回流程。诊断可以改变修复对象,生成候选不自动获得发布权。
2. 从轨迹提炼技能:先冻结参照
多次执行可能同时揭示相同问题。若每发现一条经验就立即修改技能,后续轨迹面对的参照已经变化,很难判断哪些建议互相兼容。Trace2Skill 的一个关键做法,是围绕固定技能快照分析局部执行经验,再分层合并成候选补丁。1
成功轨迹告诉系统哪些步骤值得保留,失败轨迹帮助定位缺失或错误。局部分析器不必一次阅读全部日志;合并阶段再处理重复建议与冲突。这个结构将“分析大量经验”与“维护一份一致产物”分开,但合并出的文本仍然需要独立验收。
在本文案例中,两个分析器可能分别建议“增加公式保护检查”和“对输出统一转值”。两条建议都可能在各自任务里正确,合在一起却互相冲突。合并器需要保留条件:前者适用于用户要求可编辑公式的输出,后者只适用于明确要求静态导出的任务。出现频率更高的建议,不应自动覆盖另一种合法需求。
Trace2Skill 还提供了一个很具体的检查提醒:公开固定版本的表格技能片段中,文字要求按降序删除行,但对已经降序的列表再次执行 reversed,会得到升序。2 这只是一个局部片段的一致性问题,不能用来否定整体研究;它说明自然语言经验、示例代码与执行断言需要共同检查。
例如下面的教学补丁,把“按原始行号删除”所要求的顺序写成可执行表达,并提醒验证剩余内容。具体工作表 API 由实际工具决定。
# 教学示例:删除时保持未处理的原始行号稳定。
for row_index in sorted(set(rows_to_delete), reverse=True):
    delete_row(row_index)
verify_remaining_rows_and_formulas()
删除顺序正确还不够:原始索引是否包含表头、合并单元格如何处理、公式引用是否按预期变化,都可能需要额外测试。候选可以只解决其中一个明确问题,不必承诺覆盖所有表格操作。
3. 从合理建议到可接受更新
SkillOpt 与 SkillGrad 都利用执行反馈改进外部技能,但关注的位置不同。SkillOpt 强调受控提议、编辑与选择;SkillGrad 进一步考虑规则应放在哪个披露层,以及怎样积累诊断信号。34
SkillOpt 在固定目标模型与执行框架的条件下,从成功、失败轨迹提议修改,对补丁进行整理并约束编辑规模,再用选择数据决定是否接受。被拒绝的尝试也可以成为后续提议的参考。它的价值不在“多反思一遍”,而在于修改理由与接受理由不是同一份证据。
SkillGrad 关注另一种常见失败:规则并非缺失,而是放错了位置。主文塞满长尾例外,会增加每次阅读的负担;重要前提只写在附件末尾,又可能根本没有被读到。将长期有效的主路径、条件性补充和脚本资源分层,需要同时考虑触发、披露和实际执行。
以下比较的是同一候选更新。所有字段为教学表达,不是上述项目的共同接口。
| 决策 | 粗略做法 | 更可检查的做法 |
|---|---|---|
| 为什么修改 | “这次失败了” | 指出失败证据、责任对象与可检验假设 |
| 修改什么 | 重写整份技能 | 保留有效主路径,只改相关步骤或资源 |
| 放在哪里 | 全部追加到正文 | 按适用频率与执行依赖选择披露层 |
| 是否接受 | 生成器认为更清楚 | 同一预算下比较候选与原版本 |
| 如何解释结果 | 只展示最佳分数 | 同时记录修复、回归、成本和被拒候选 |
这里有两个独立预算:优化器寻找候选所花的成本,以及候选部署后完成任务的成本。更短的最终技能,可能来自很昂贵的搜索;廉价生成的规则,也可能让后续每次执行都增加大量检查。只报其中一本账,会让架构决策失真。
完整评测方法见收益评测篇。在优化循环内部,最关键的一条是:选择集可以用于反复挑选候选,最终测试集应隔离。若把测试失败也继续反馈给优化器,这批任务就已经参与开发,需要新的独立测试来判断泛化。
4. 用一个例子检查整个控制过程
回到透视表失败。先冻结原始技能、工具版本和样本集,再提出两种假设:H1 是技能没有区分指标字段和维度字段;H2 是工具的新接口不再接受旧参数。两者对应不同修复对象,应先用最小测试区分。
若相同参数通过兼容层能够正确执行,正文重写可能不是首要动作。若接口调用成功但参数语义始终错误,则可以提出技能候选:增加字段分类步骤、调整示例,或在生成后重新读取透视表对象检查布局。
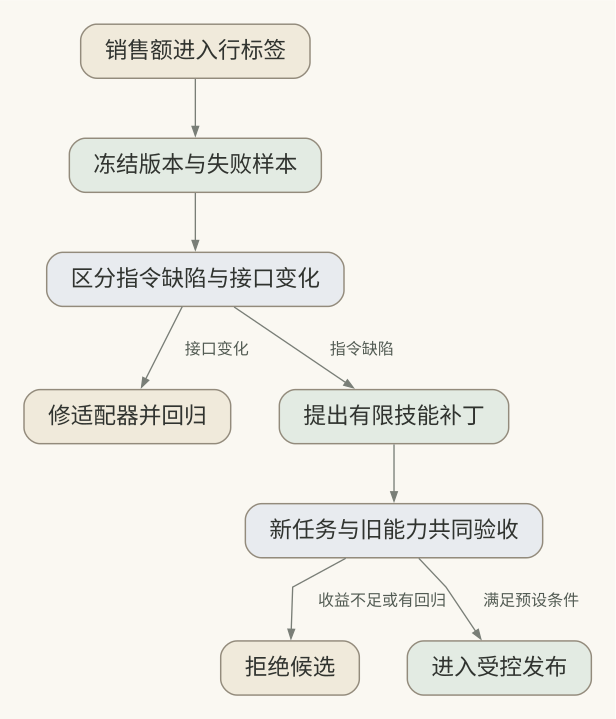
图 2:教学诊断流程。分支由测试证据决定,模型提出的解释只是假设。
假设候选 A 增加正确的字段说明,候选 B 增加文件保存后的对象检查。它们可以分别测试,也可以测试组合;组合结果不能由两个单独分数相加得到。额外检查可能修复错误,也可能因为工具不支持而引入新失败。
验收时至少包含三类任务:原来出错的相似任务、不同列名或布局的新任务、原版本已经稳定完成的任务。第三类用于发现回归。只有第一类改善,说明问题被局部修复;对第二类的改善才支持迁移;三类都通过,仍然只适用于已覆盖的环境与需求。
接受条件应在看候选成绩之前写清。可以选择“质量达到底线时优先降低成本”,也可以选择“允许有限成本增加以减少严重错误”。授权与数据安全等硬约束不参与平均分抵消。没有统一权重适用于所有产品,优化器不能从失败日志中自动推导业务取舍。
5. 从单次优化走向持续学习
单次任务修好之后,下一个问题是怎样让未来任务受益。Memento-Skills 把技能作为可写的外部程序知识,采用读取、执行、写回的循环;更新的不只是对话摘要,还可以包括技能文件与资源。5
这种做法能让经验持续影响后续任务,也带来新的风险:错误规则会被重复读取,相似技能互相挤占检索位置,某个高频任务的优化可能伤害低频需求。技能库增长只是状态变化,不能作为学习成功的指标。
我会把快速记录与慢速发布分开。执行结束后先记录候选经验及其适用条件,允许同一批经验积累出足够证据;经过选择与回归后,再更新稳定技能快照。线上任务使用的快照应可追溯,实验组积累的学习状态也不能静默流入基线组。
知识巩固还需要维护决策:新增技能、修改旧技能、拆分过宽的技能,或撤回已经失效的规则。选择应基于任务覆盖与行为证据。低频不等于无价值,两个描述相似的技能也可能对应不同权限和环境。具体库治理见冲突治理与版本发布篇。
更大的编辑范围需要更清楚的边界
RRSI 将改进对象扩展到 Agent Harness,包括提示、控制流、工具与上下文管理。6 它将候选提议与保留决策分开,并在选择中考虑质量、成本与约束。这里吸收的是 W39 研究底稿中的方法,不把历史材料当作本周新闻。
这也提醒我们:若一次候选同时修改路由、技能与工具,最终涨分只能首先归给整个变更集合。要判断某个 Skill 的贡献,需要另做控制实验。held-out 或域外测试参与了搜索,就不再是独立的迁移证据。
RRSI 并不等于单技能文本优化。本文将它放在边界讨论里,是为了说明控制器必须知道允许编辑的对象与范围,不能因为技术上能修改更多文件,就默认这些修改都应被自动保留。
6. 停止条件也是优化能力
持续运行的优化器很容易把“还能提出建议”当成“值得继续”。实际上,当候选收益不稳定、剩余预算不足、诊断无法区分或环境持续变化时,继续搜索可能只是在追逐噪声。
| 应停止或转交的信号 | 下一步 |
|---|---|
| 修改效果小于测量不确定性 | 保留原版本,补样本或重设实验 |
| 反复修复同一小批任务 | 检查过拟合与任务切分 |
| 收益来自更多重试或权限扩大 | 重新比较预算与约束,不归因于文本改进 |
| 工具、模型或验收标准变动 | 建立新快照,重新界定实验 |
| 无法确认副作用是否发生 | 先核查状态,再考虑恢复 |
停止后要留下可复用的结论:哪些假设被否定,哪些补丁已经测过,什么证据仍然缺失。这样下一轮不会从相同的猜测重新开始。保留失败记录的目的,是提高下一次决策质量,而不是让每次用户请求都携带全部失败历史。
在工程上,我会先实现一个很小的闭环:只允许修改一种技能资产,绑定一个固定验收器,保留完整补丁记录,能够拒绝候选并恢复原版本。等收益与失败都可解释后,再扩大编辑对象和自动化程度。
持续改进最终留下的应该是更可靠的能力,以及知道这项能力何时有效的证据。 文件数量、反思轮数和训练曲线都可以帮助观察过程,但它们不能替代未来任务上的质量、成本与约束表现。
参考资料
- Trace2Skill,arXiv:2603.25158v5:局部轨迹分析与候选合并。
- Trace2Skill 固定技能产物:本文局部代码一致性案例的来源。
- SkillOpt,arXiv:2605.23904v2:受控更新与选择;固定编辑实现。
- SkillGrad,arXiv:2605.27760v1:分层技能优化;固定实现。
- Memento-Skills,arXiv:2603.18743v1:读取、执行与经验写回;作者仓库。
- RRSI,arXiv:2609.24972v2:更大编辑范围下的提议与保留;固定选择实现。
资料以固定研究版本及 2026 年 9 月底稿为界,2026-10-07 合并修订。本文没有独立重跑模型训练或 benchmark;教学过程不代表上述方法已在同一个生产系统中联合验证。
